
電気配線が先に限界に来る
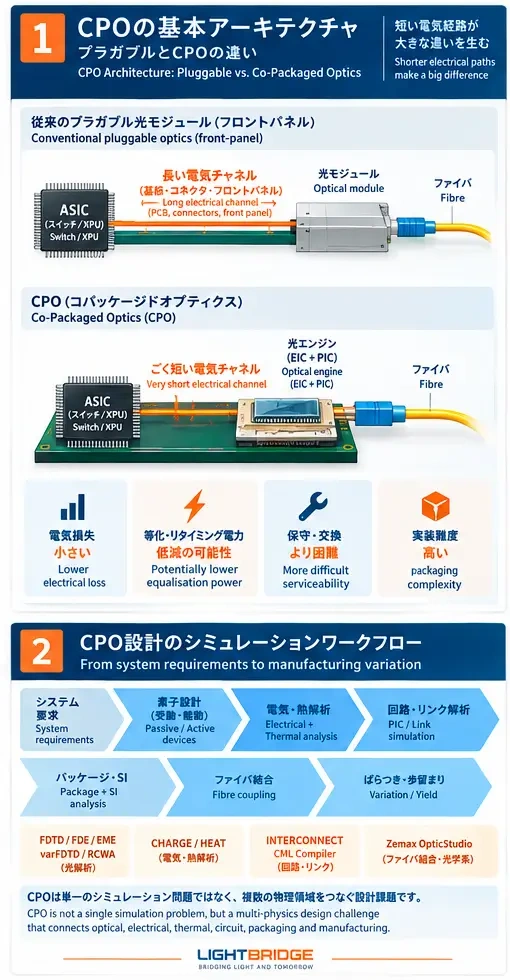
800Gb/sのポートを1台のスイッチに128個並べたい、という要求は、光よりも先に電気の側を苦しくする。レーン速度を上げれば、基板・コネクタ・フロントパネルを通る損失は周波数とともに増える。SerDesを新しい世代にしても、その間のチャネルが無料になるわけではない。NVIDIAは、200Gb/sレーンのプラガブル構成で電気経路の損失が最大22dBに達し、同社のCPO構成では約4dBになるとしている(同社公表値、比較条件は非公開)。
損失が増えれば等化とリタイミングの電力が増え、銅の届く距離も短くなる。1Gb/sで10m届いた電気ケーブルは、100Gb/sでは1m前後、800Gb/sでは0.5mを下回る(Benyahyaら, SIGCOMM 2025)。答えの一つが、光エンジンをASICの近くまで動かすこと、すなわちCo-Packaged Optics(CPO)である。
CPOで何が変わるのか
CPOは「フォトニクスとASICを同一ダイ上に作る」という意味ではない。電子集積回路(EIC)と光集積回路(PIC)は別のダイやチップレットとして作られ、先端パッケージング技術で一つのパッケージにまとめられる。TSMCのCOUPEは、SoIC-XでEICダイをPICダイの上に積層し、CoWoSパッケージに載せる構成として説明されている。
本質は製造方法ではなく距離だ。プラガブルの「ASIC → 長い電気チャネル → フロントパネルの光モジュール → ファイバ」が、CPOでは「ASIC → ごく短い電気チャネル → パッケージ内または近傍の光エンジン → ファイバ」になる。
| プラガブル光モジュール | CPO | |
|---|---|---|
| 高速電気経路 | 長い(基板+コネクタ+フロントパネル) | 短い(パッケージ内〜近傍) |
| 光エンジンの位置 | フロントパネル | ASICと同一パッケージ/近接 |
| 保守・交換 | モジュール単位で容易 | パッケージ単位で困難 |
| 熱環境 | ASICから比較的分離 | ASICの発熱と結合 |
| 実装難度 | 低い | 高い(光結合・ファイバ実装を含む) |
利点は電気経路の短縮から出る。損失と等化負荷の低減、帯域密度、電力だ。ただし電力の数字は境界を確認したい。ベンダーの「プラガブル比3.5倍」級の値は光インターコネクト部分だけを対象にしており、Broadcomは第3世代CPOについて「光インターコネクト電力の70%削減」と範囲を明示している。スイッチASICのSerDes・電源・冷却まで含めた査読論文の試算では、102.4Tb/sスイッチ全体でDSPプラガブル6,400W対CPO4,093W、約36%減になる(Evans, J. Lightwave Technol. 2026)。同じ技術でも境界を変えれば3.5倍と1.5倍が並び立つ。
課題も具体的だ。光エンジンをASICと同じパッケージに入れれば熱の逃げ道を共有する。光結合とファイバ実装は組立工程になり歩留まりに直接効き、モジュール単位の交換ができないため故障時の扱いも変わる。なお、CPOが必ずDSPやリタイマを不要にするという言い方は正確ではない。アーキテクチャ依存であり、特定の実装について述べるならその実装を指定すべきものだ。
光源の置き場所も、ここで新たに発生する設計判断だ。外部光源はフロントパネル型のプラガブルとして実装されることが多く、OIFのELSFP実装合意がこの形状を規定している。光エンジンの中で最も温度に敏感で信頼性が厳しいのがレーザなので、独立に冷却でき、パッケージに触らずに交換できる場所に置ければ熱と運用の両方に効く。
一方で集積光源も実在する。Intelは3,200万個を超えるオンチップレーザを出荷したとしており、同社の光I/OチップレットはDWDMレーザアレイをフォトニックダイ上に集積している。どちらが普遍的に優れているとは言えない。詳細な学術比較では、素子単体の効率は集積光源のほうが劣るにもかかわらず、結合損失を避けられファイバ本数にも縛られないため、集積光源のほうが総電力が小さいという結果が出ている(Buscainoら, J. Lightwave Technol. 2021)。前提が変われば向きも変わる。
スケールアップとスケールアウト
AIクラスタの配線は性質の異なる二層に分かれる。スケールアップはアクセラレータ同士を結ぶ層で、レイテンシ要求が厳しく距離が短い。ここは歴史的に銅が強い。短い受動銅リンクは光トランシーバもレーザも要らないので、その分の電力が丸ごと不要になり、故障率も短距離光より一桁以上低い。ただし電力がゼロというわけではなく、SerDesと電気インタフェース自体は電力を消費する。銅が省くのはその上に載る光の分だ。NVL72級のラックで銅配線を現在の光に置き換えると、1ラックあたり20kW程度、GPU 20台分の追加になるという見積もりもある。
スケールアウトはラック間・スイッチファブリック側で、すでに光が当たり前の領域だ。CPOが議論になっているのは、この境界が動き始めているからである。レーン速度が上がるほど銅の届く距離は短くなり、銅で足りていた区間が光の候補になる。
シリコンフォトニクスが使われる理由
CPOの光エンジンに入る素子の種類は多くない。導波路、分岐器、方向性結合器、変調器(マッハツェンダ型またはリング型)、受光器、WDMの合分波器、ファイバとの結合部(グレーティングカプラまたはエッジカプラ)、そして光源の接続点である。
シリコンフォトニクスがこの組み合わせに向いているのは、屈折率差が大きく素子を小さく作れること、CMOSの製造インフラと300mmウェハを使えることによる。マッハツェンダ型変調器が数mm規模になるのに対し、200Gb/s PAM4のリング変調器は半径12μmで実証されている(Yuanら, Nat. Commun. 2024)。CPOが要求するチャネル数では、この差が光エンジンの収まりを決める。ただしシリコン以外では成立しない、という話ではない。SiNは低損失、InPは利得で必要になる。
本題:実際に何を解析する必要があるのか
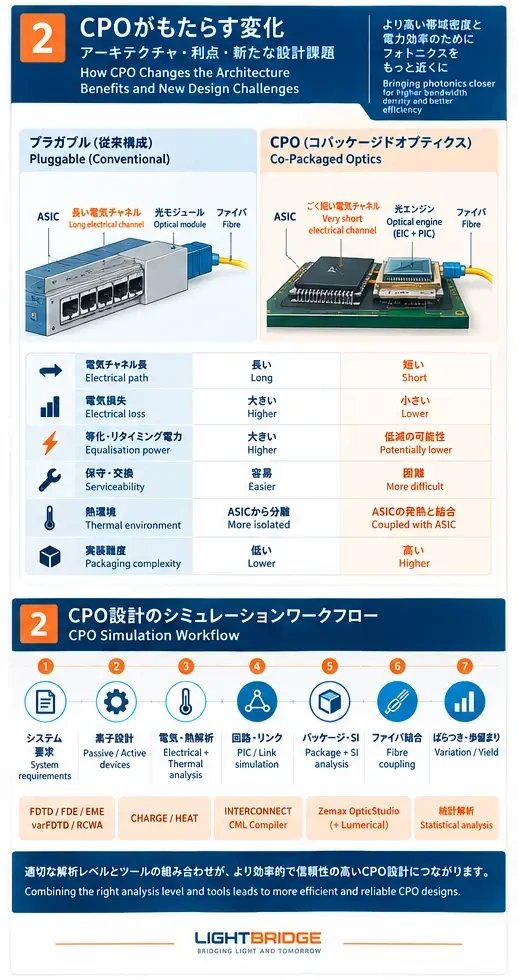
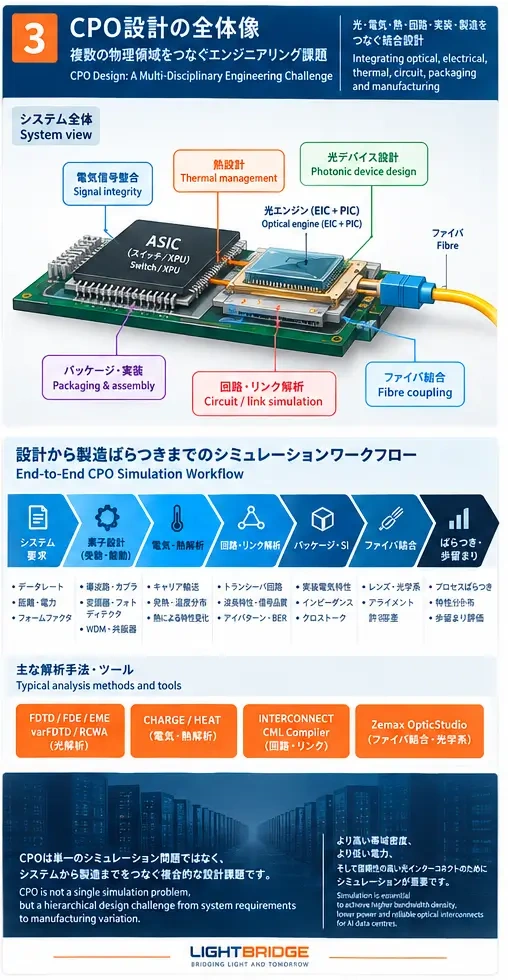
CPOは一つのシミュレーション問題ではない。光・電気・熱・回路・実装・製造ばらつきが階層的に結合した問題群である。
A. 受動素子
どのモードが伝搬するか。挿入損失はいくらか。形状が数nmずれたときにどれだけ変わるか。波長依存性とクロストークは。
素子の性質で手法が変わる。断面の実効屈折率・群屈折率・分散・曲げ損失ならFDEで断面の固有モードを解く。長い断熱テーパやMMIの長さを決めるならEMEが向く。断面が不変なセルへの分割と単一波長ごとの計算という制約はあるが、素子長を振り直すときに再計算が不要なので、テーパ長の最適化が現実的な時間で回る。グレーティングカプラや強い散乱、面外結合が本質になる部分は3D FDTD。リング共振器やMZIを含む数百μm規模の平面回路ならvarFDTDで時間応答が得られるが、垂直方向のスラブモード間結合が小さいという仮定の上に成り立つ。すべての受動素子を3D FDTDで解くのは、精度ではなく設計スケジュールの問題として得策ではない。
B. 変調器
変調器は光だけを見ていても設計できない。電圧印加 → 空乏層のキャリア分布 → 屈折率と吸収の変化 → 光モードの応答 → 変調特性、という連鎖になる。
CHARGEでポアソン方程式とドリフト拡散方程式を自己整合的に解き、バイアスごとのキャリア分布と接合容量を得る。その分布を屈折率変化に変換して光解析へ渡し(LumericalではSoref-BennettやDrudeモデルを使う受け渡し用オブジェクトがある)、FDEやFDTDで実効屈折率変化と損失を電圧の関数として求める。リング変調器なら、実務的な順序はFDTD(結合部)→ FDE(受動導波路)→ CHARGE(能動領域)→ FDE(電圧依存)→ 回路シミュレーションだ。
C. 受光器
受光器も同じ構造で、入射光が吸収層でどう分布し、それがどう電気応答になるかを追う。Ge-on-Si受光器では、FDTDで光学的生成率の空間分布を求め、それをCHARGEの連続の式のソース項に与えて応答度・暗電流・帯域を評価する。UTC型やアバランシェ型では律速要因が違うので、見るべき量も変わる。
D. 熱
ここがCPOで最も具体的に効く。51.2Tb/sクラスの液冷CPOパッケージを解析と実測で評価した研究では、スイッチASIC 750Wに対して光エンジンが1個64W×8個という配分で、ASIC接合部が98.3℃、最も高温の光モジュールが35.1℃という結果が報告されている。同じ研究は、光モジュール間の許容温度差を4℃としている(Wuら, Front. Optoelectron. 2025)。
4℃は換算すると余裕のある数字ではない。リング変調器の共振波長は1℃あたり約0.1nm動く。WDMのチャネル間隔が100〜200GHz、つまりC帯で0.8〜1.6nmだとすれば、数℃の勾配はチャネル間隔に対して無視できない割合になる。同じ物理がチューニング電力も決め、リング変調器のπ位相シフトに約39mWという実測値が報告されている。素子数の多い光エンジンではこれが積み上がる。
つまりパッケージの温度分布は信頼性の話ではなく、光回路性能の入力になる。HEATで熱伝導と自己発熱を解き、ヒータ間の熱クロストークを結合行列として抽出して回路側に渡す手順が現実的だ。パッケージ全体の温度分布をIcepakで求め、その温度マップを回路シミュレータに読み込んで、温度依存のコンパクトモデルでチャネルごとのアイ図とBERまで見るワークフローも公式ドキュメントに例がある。
E. 回路・リンク
素子が個別に正しく解けていても、リンクが成立するかは別問題である。素子解析 → コンパクトモデル抽出 → PIC/トランシーバ回路 → 波長応答 → アイ開口・BER・リンクマージン、と進む。
Lumerical INTERCONNECTは周波数領域のSパラメータ解析と時間領域の2モードを持ち、WDMのチャネル数を増やしたときのクロストークや、単体では問題なく見えた変調器の消光比によるアイ劣化が現れる。素子解析の結果を持ち込む道具がCML Compilerで、統計データを与えればコーナー解析とモンテカルロ解析に対応するモデルになる。
この段階の値は検証ではなく素子仕様の決定にある。リンクが要求を満たさないとき、変調器の消光比を上げるのか、結合損失を削るのか、チャネル間隔を広げるのかは、回路レベルでしか判断できない。
F. 電気の信号品質
電気経路が短くなっても電気解析は不要にならない。短い経路では、インピーダンス不整合や寄生成分が予算に対して相対的に効きやすい。インターポーザやRDL上の配線のインピーダンスと反射、ドライバから変調器までの寄生RLC、チャネル間のクロストーク、TSVやマイクロバンプの高周波損失が対象になる。
公式のCPO事例には、インターポーザ上の信号経路を3D電磁界解析でSパラメータ化し、ドライバ回路と光回路シミュレーションに繋いで、送信側・光チャネル・受信側それぞれのアイ図を見るものがある。RF配線の寄生を入れた途端にアイ開口がほとんど潰れる例も示されている。
G. ファイバとチップの結合
CPOで最も泥臭く、かつ最も歩留まりに効くのがここである。方式は大きく二つ。エッジカプラは断面から入れる方式で、広い波長帯域と低損失が得やすく、あるファウンドリ標準素子ではモードフィールド径3μmのレンズドファイバに対して約1.5dB/面が実測されている。グレーティングカプラは面から入れる方式でウェハレベル検査に向くが、同じ比較では約3dB、1dB帯域が30nm程度と狭い(Rannoら, Photonics Res. 2024)。損失と帯域を検査性と組立フローで買っているということだ。
難しいのはスケールの飛びだ。導波路のモード径はサブμm〜μm、シングルモードファイバは約10μm、ファイバのクラッド径は125μmある。最後の数字がパッケージを縛る。直付けする限りピッチは約127μm以上で、素子端1mmあたり8本が上限になる。一方、量産で使えるピック&プレース装置の実力は3μm前後だ。カプラの許容位置ずれが、そのまま使える組立装置とコストを決めてしまう。
この飛びを扱うには二つの領域を繋ぐ必要がある。導波路のモードはFDEやFDTDで、パッケージ側のマイクロレンズやファイバの幾何配置と位置ずれ予算はZemax OpticStudioの光線・物理光学伝搬で扱う。両者はZBF形式のビームファイルで受け渡しでき、公式のCPO事例には、マイクロレンズ付きエッジカプラをFDE → OpticStudio(POP、位置ずれを含む)→ FDTD → EMEの順で解く例がある。マイクロレンズで許容位置ずれを緩める判断を、数字で評価できる。
H. 製造ばらつきと歩留まり
公称値のシミュレーションは出発点であって成果物ではない。導波路幅が1nmずれるとフィルタの波長は約0.9nm動き、膜厚のずれはその約2倍効く(Bogaertsら, IEEE JSTQE 2019)。ウェハスケールの実測では、幅1,200nmの導波路が幅480nmよりばらつきが小さいことも示されている。ファブの性質ではなく設計で選べる余地がある。
ばらつきはチャネル配置が崩れる形と、それを熱チューニングで戻す電力が増える形で跳ね返る。だから設計の最後は分布で見る。コンパクトモデルに統計パラメータと相関長を与えてモンテカルロを回し、消光比・リンク損失・チューニング電力の分布から歩留まりを推定する。CPOの光エンジンは同じ素子が数mmにわたって多数並ぶので、レイアウト座標を取り込んで空間相関を反映させる手法も効いてくる。
解析の進め方と、ソフトを選ぶ前に決めること
A〜Hを一つの流れに並べると、システム要求 → 受動・能動素子の解析 → 電気・熱解析 → コンパクトモデル抽出 → PIC/リンクシミュレーション → パッケージと信号品質の評価 → ファイバ結合 → 製造ばらつき・歩留まり、となる。ただし全プロジェクトをこの順で進めるべきだという意味ではない。既存のPDKで素子が揃っているならリンクから始めたほうが早く、熱が支配的な案件なら熱を先に置いて素子仕様を縛る。問題の切り分けなら症状から逆に辿る。
CPOの相談で一番多い行き違いは、「どのソフトを使うべきか」から話が始まることだ。解析ソフトを先に選ぶのではなく、何を知りたいかを先に決めたほうが早い。
| 知りたいこと | 主な手法 | 得られるもの |
|---|---|---|
| 導波モード・実効屈折率・曲げ損失 | FDE | 回路モデルと結合設計の前提 |
| 長いテーパ・MMIの素子長 | EME | Sパラメータ、最適長 |
| グレーティング結合・散乱・面外結合 | 3D FDTD | 結合効率、波長・偏光依存 |
| 周期構造・多層膜 | RCWA | 回折効率(横方向が非周期なら不可) |
| キャリア分布・接合容量 | CHARGE | 屈折率変化と帯域の入力 |
| 温度分布・熱クロストーク | HEAT | 共振シフト、チューニング電力 |
| リンクのアイ開口・BER・歩留まり | INTERCONNECT | 素子仕様への折り返し |
| パッケージ光学・ファイバ実装公差 | Zemax+Lumerical | 組立公差と装置の選択 |
問いが決まれば、手法はほぼ一意に決まる。
日本国内の動き
国内でも光電融合は具体的な開発段階に入っている。産業技術総合研究所は2025年4月1日に光電融合研究センター(英名 Photonics-Electronics Integration Research Center)を設立した。デバイス・パッケージング・ネットワークの各階層を扱う構成で、光パッケージング研究チームは光集積回路を内蔵したパッケージ基板やファイバ接続を対象にしている。同センターにはシリコンフォトニクスコンソーシアム(MPWとスーパークリーンルームの利用を含む)と、光電コパッケージ技術検討部会を持つ次世代グリーンデータセンター協議会が置かれており、事前競争的な議論の場としては国内の中心にある。産業側で日本勢が押さえているのは、G節で見たとおり歩留まりを左右する光源と実装の周辺で、外部光源では古河電気工業が2022年にCPO向け外部光源を製品化している。
設計の入口をどこに置くか
受動素子に3D FDTDを何週間も回しても、熱の見積もりを外していればリンクは要求を満たさない。逆に熱と回路だけを見ていても、結合部の公差が組立装置の実力を超えていれば量産に乗らない。難しいのは個々の素子ではなく、この切り分けである。
本文で挙げた手法のうち、FDE・EME・varFDTDはLumerical MODE、CHARGEとHEATはLumerical マルチフィジックスに含まれる。LightBridgeはAnsys LumericalとZemax OpticStudioの取り扱いと技術サポートを行っており、PIC設計ワークフロー、シリコンフォトニクス、光通信・光トランシーバの各ページで解析の組み立て方を整理している。試作に進む段階では、MPWを含むファウンドリの選定と設計データ準備の相談も受けている(対応範囲は対象ファウンドリのPDKとデザインルールによる)。
CPOの案件で最初に決めるべきなのは、ソフトの構成ではなく、いま答えが必要な問いがどれかということだ。
参考文献
- A. F. Evans, “Data Center Switch Power Consumption Comparison Between Co-Packaged Optics and Pluggable Transceivers,” J. Lightwave Technol. 44(16), 7158–7164 (2026).
- Y. Wu et al., “Simulation and experimental investigation of liquid-cooling thermal management for high-bandwidth co-packaged optics,” Front. Optoelectron. 18, 11 (2025).
- Y. Yuan et al., “A 5×200 Gbps microring modulator silicon chip,” Nat. Commun. 15, 918 (2024).
- M. A. Buscaino et al., “External vs. Integrated Light Sources for Intra-Data Center Co-Packaged Optical Interfaces,” J. Lightwave Technol. 39(7), 1984–1996 (2021).
- W. Bogaerts, Y. Xing, U. Khan, “Layout-Aware Variability Analysis, Yield Prediction, and Optimization in Photonic Integrated Circuits,” IEEE J. Sel. Top. Quantum Electron. 25(5) (2019).
- A. Parsons et al., “Foundry-enabled wafer-scale characterization and modeling of silicon photonic DWDM links,” Nanophotonics 14(27), 5363–5374 (2025).
- G. Ranno et al., “Highly efficient fiber to Si waveguide free-form coupler for foundry-scale silicon photonics,” Photonics Res. 12(5) (2024).
- D. M. Weninger et al., “Advances in waveguide to waveguide couplers for 3D integrated photonic packaging,” Light Sci. Appl. 15, 17 (2026).
- H. Benyahya et al., “MOSAIC: Breaking the Optics versus Copper Trade-off with a Wide-and-Slow Architecture and MicroLEDs,” ACM SIGCOMM 2025.
- NVIDIA, “Scaling AI Factories with Co-Packaged Optics for Better Power Efficiency”(2025年8月18日)および NVIDIA Silicon Photonics 製品ページ.
- Broadcom, “Broadcom Announces Tomahawk 6 – Davisson”(2025年10月8日).
- TSMC, “TSMC Showcases New Technology Developments at 2024 North America Technology Symposium”(2024年4月24日)— COUPE / SoIC-X.
- OIF, “External Laser Small Form Factor Pluggable (ELSFP) Implementation Agreement”(2023年8月8日).
- Intel, “Intel Shows OCI Optical I/O Chiplet Co-packaged with CPU”(2024年3月21日、同年10月更新).
- 産業技術総合研究所 光電融合研究センター(2025年4月1日設立).
- Ansys Optics ドキュメント(FDTD / MODE / CHARGE / HEAT / INTERCONNECT / CML Compiler / Zemax interoperability / Co-Packaged Optics 事例集).
設計・解析について技術相談
各アプリケーションの設計フロー構築や、解析モデルの妥当性評価について、専門エンジニアが実務に即してご相談に応じます。